Sztuczna inteligencja w medycynie to w 2026 r. nie jeden „cyfrowy lekarz”, tylko kilka różnych narzędzi. Asystenci i wyszukiwarki odpowiadają na pytania pacjentów i lekarzy. Modele decyzyjne wybierają jedną z kilku możliwych odpowiedzi — rozstrzygają np., czy pacjent spełnia kryteria badania klinicznego. Roboty chirurgiczne przenoszą ruchy chirurga na narzędzia. Osobną grupą są algorytmy wbudowane w wyroby medyczne, które oceniają zdjęcia rentgenowskie, tomografię czy zapis EKG.
Opisujemy, które z tych narzędzi są dostępne, jak radzą sobie w niezależnych badaniach i co dzieje się w Polsce. Na końcu wyjaśniamy, dlaczego o tempie zmian decyduje dziś nie technika, tylko dopuszczenie do leczenia.
Co jest na rynku
Asystenci dla pacjentów
W styczniu 2026 r. dwie największe firmy rozwijające modele językowe uruchomiły wersje swoich asystentów przeznaczone do spraw zdrowia. ChatGPT Health (OpenAI, 7 stycznia) to wydzielona część czatu, do której można podłączyć dokumentację medyczną i dane z aplikacji. OpenAI zastrzega, że narzędzie nie jest przeznaczone do diagnostyki ani leczenia — ma pomagać w codziennych pytaniach i w przygotowaniu do rozmowy z lekarzem.2 Claude for Healthcare (Anthropic, 11 stycznia) łączy model z bazami używanymi w ochronie zdrowia, m.in. klasyfikacją ICD-10 i bazą publikacji PubMed. Użytkownicy w USA mogą podłączyć do niego wyniki badań, a model ma informować o niepewności odpowiedzi i kierować do specjalistów.3
Jak takie narzędzie sprawdza się w praktyce, zbadał zespół szpitala Mount Sinai w Nowym Jorku. Badacze przeprowadzili z ChatGPT Health 960 rozmów opartych na 60 scenariuszach klinicznych z 21 specjalizacji, a pilność każdego przypadku ocenili niezależnie trzej lekarze. Oczywiste nagłe stany, jak udar czy ciężka reakcja alergiczna, model rozpoznawał dobrze, ale z mniej oczywistymi radził sobie słabiej. Łącznie w ponad połowie przypadków, które wymagały pilnej pomocy, zalecił mniej pilne postępowanie. Autorzy zwracają uwagę, że modele są często aktualizowane, więc ocena dotyczy jednej chwili i wymaga powtarzania.4
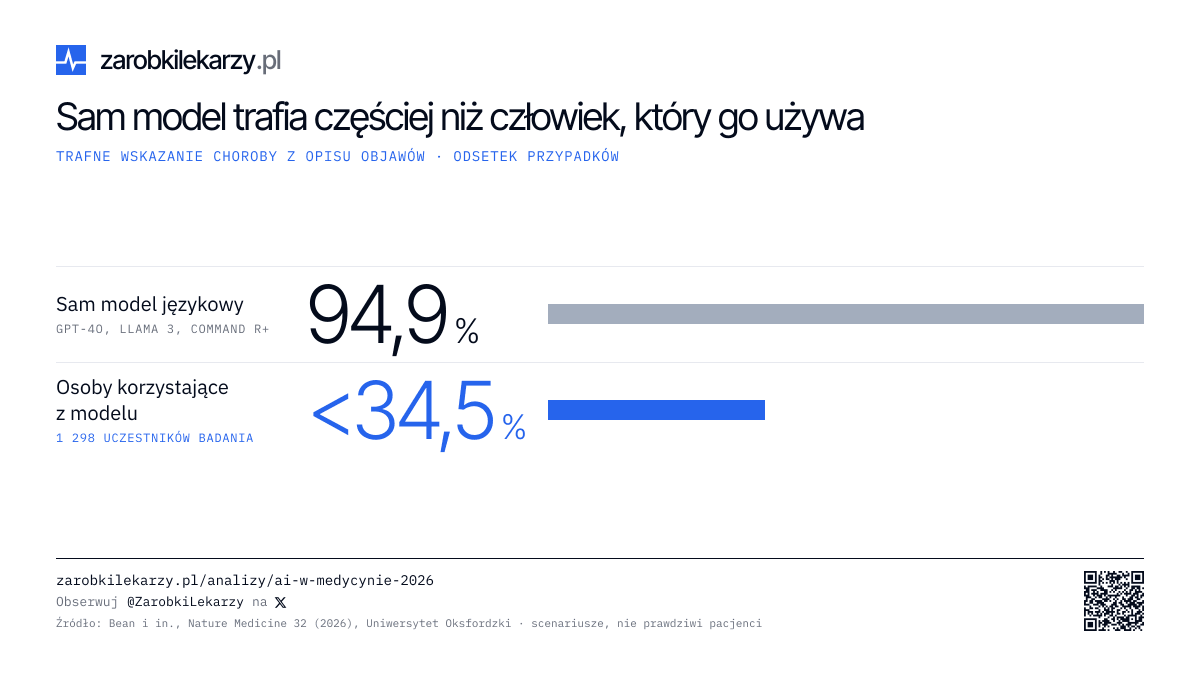
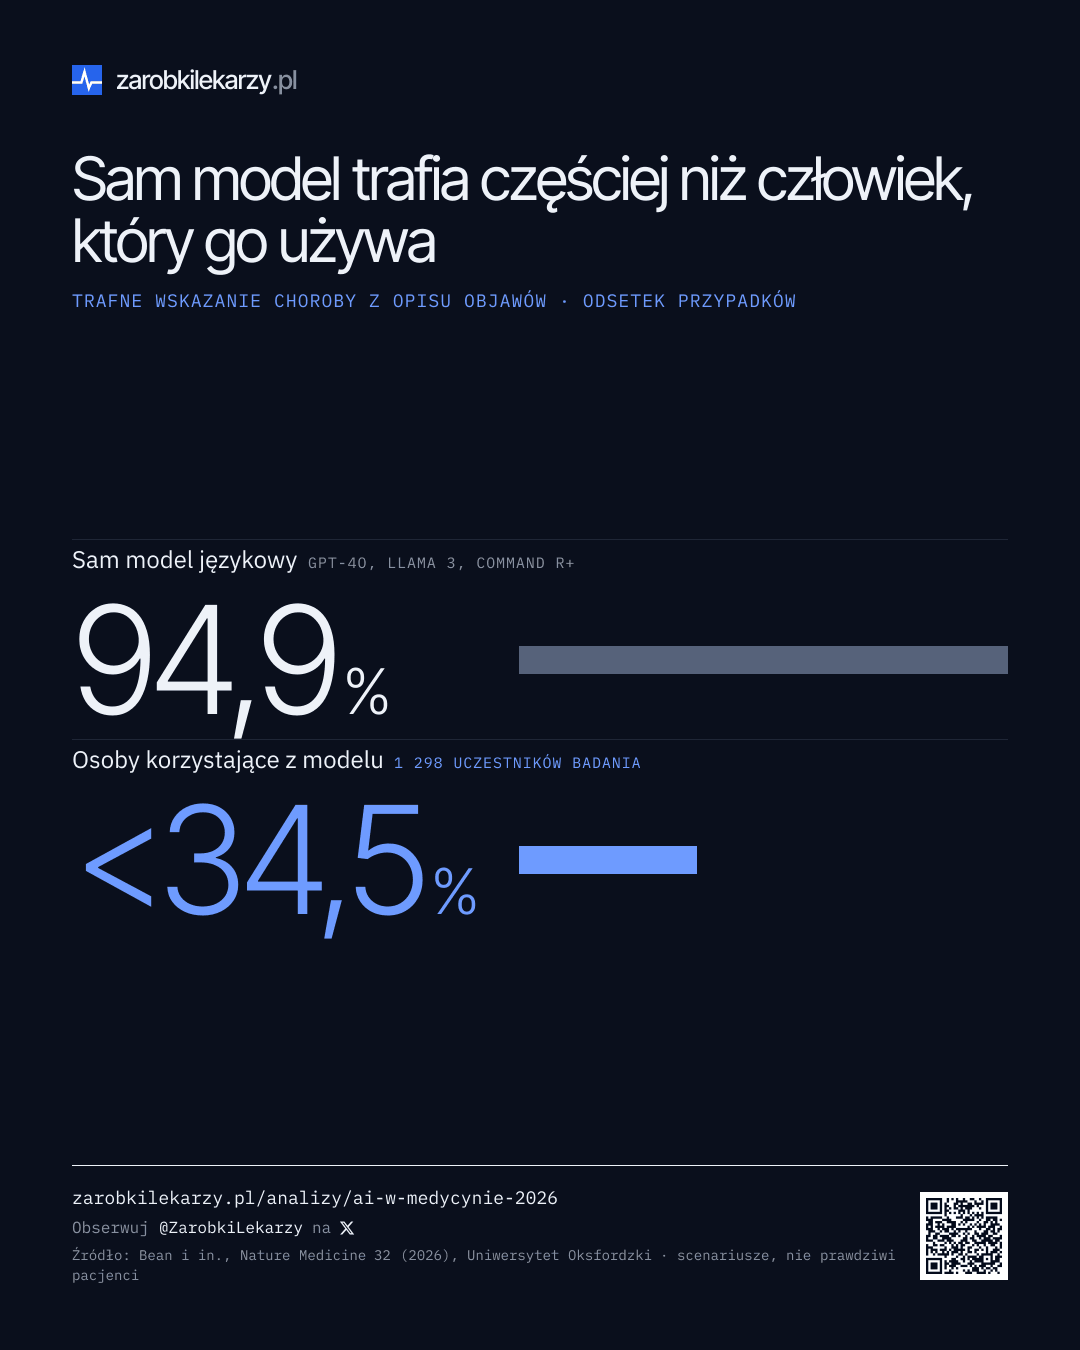
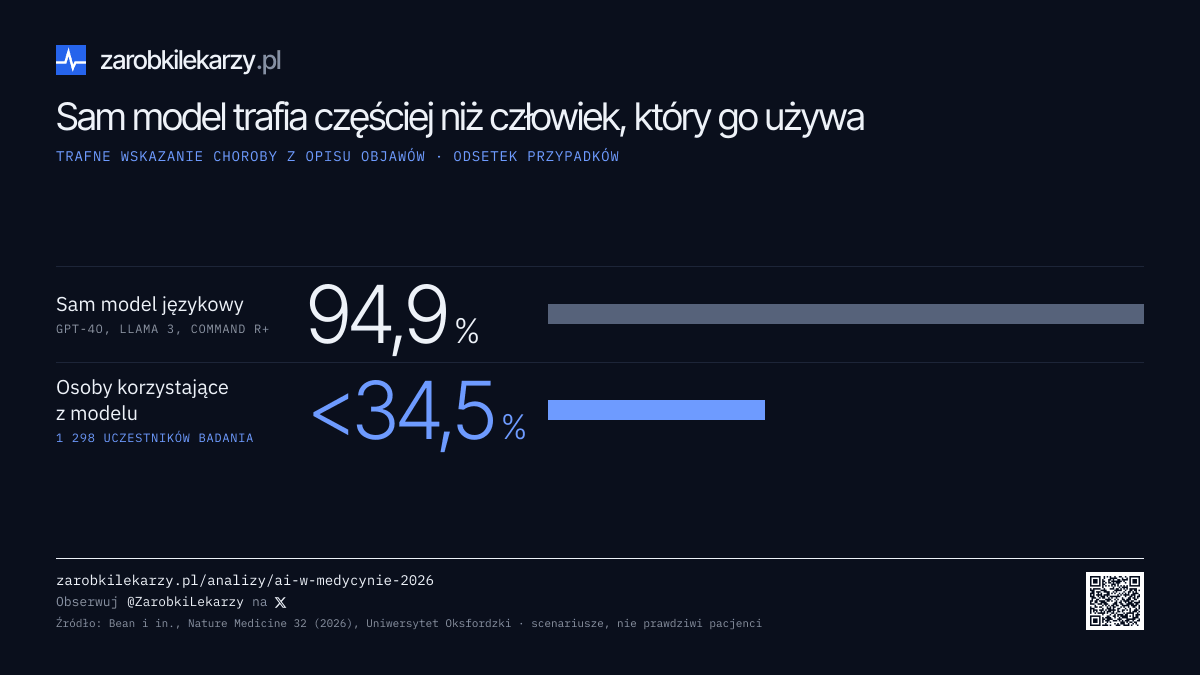
Badanie oksfordzkie, przywołane na początku, pokazuje, gdzie leży problem. Uczestnicy podawali modelom niepełne informacje, a trafne podpowiedzi modeli często do nich nie docierały. Autorzy wskazują, że standardowe testy na pytaniach egzaminacyjnych tego nie wychwytują, i zalecają badania z udziałem prawdziwych użytkowników przed wdrożeniem takich narzędzi.1
Narzędzia dla lekarzy
Najszerzej używaną wyszukiwarką wiedzy medycznej jest amerykańskie OpenEvidence. Odpowiada na pytania kliniczne na podstawie publikacji naukowych, jest bezpłatne dla zweryfikowanych lekarzy i utrzymuje się głównie z reklam, w dużej części farmaceutycznych.5 W styczniu 2026 r. spółka pozyskała 250 mln USD przy wycenie 12 mld USD i podała, że w grudniu 2025 r. jej narzędzie obsłużyło ok. 18 mln konsultacji klinicznych — to dane samej firmy.6 Utrzymywanie się z reklam przywołuje stare w medycynie pytanie: kto płaci za informację, z której lekarz korzysta przy pacjencie.
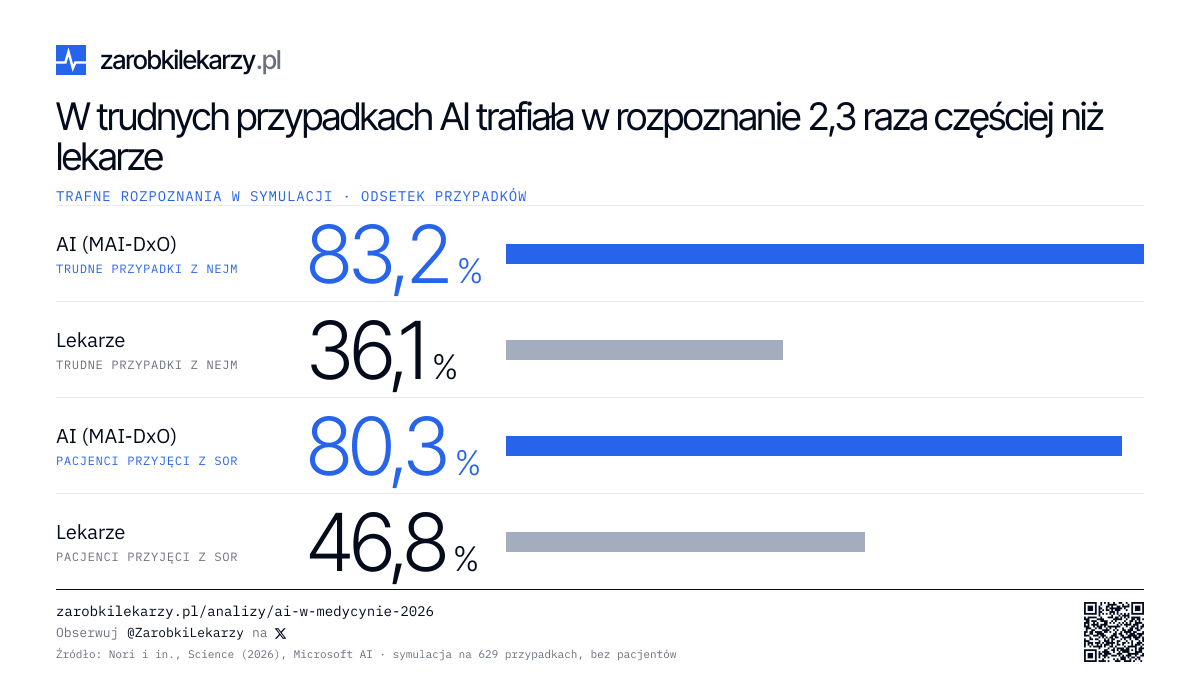
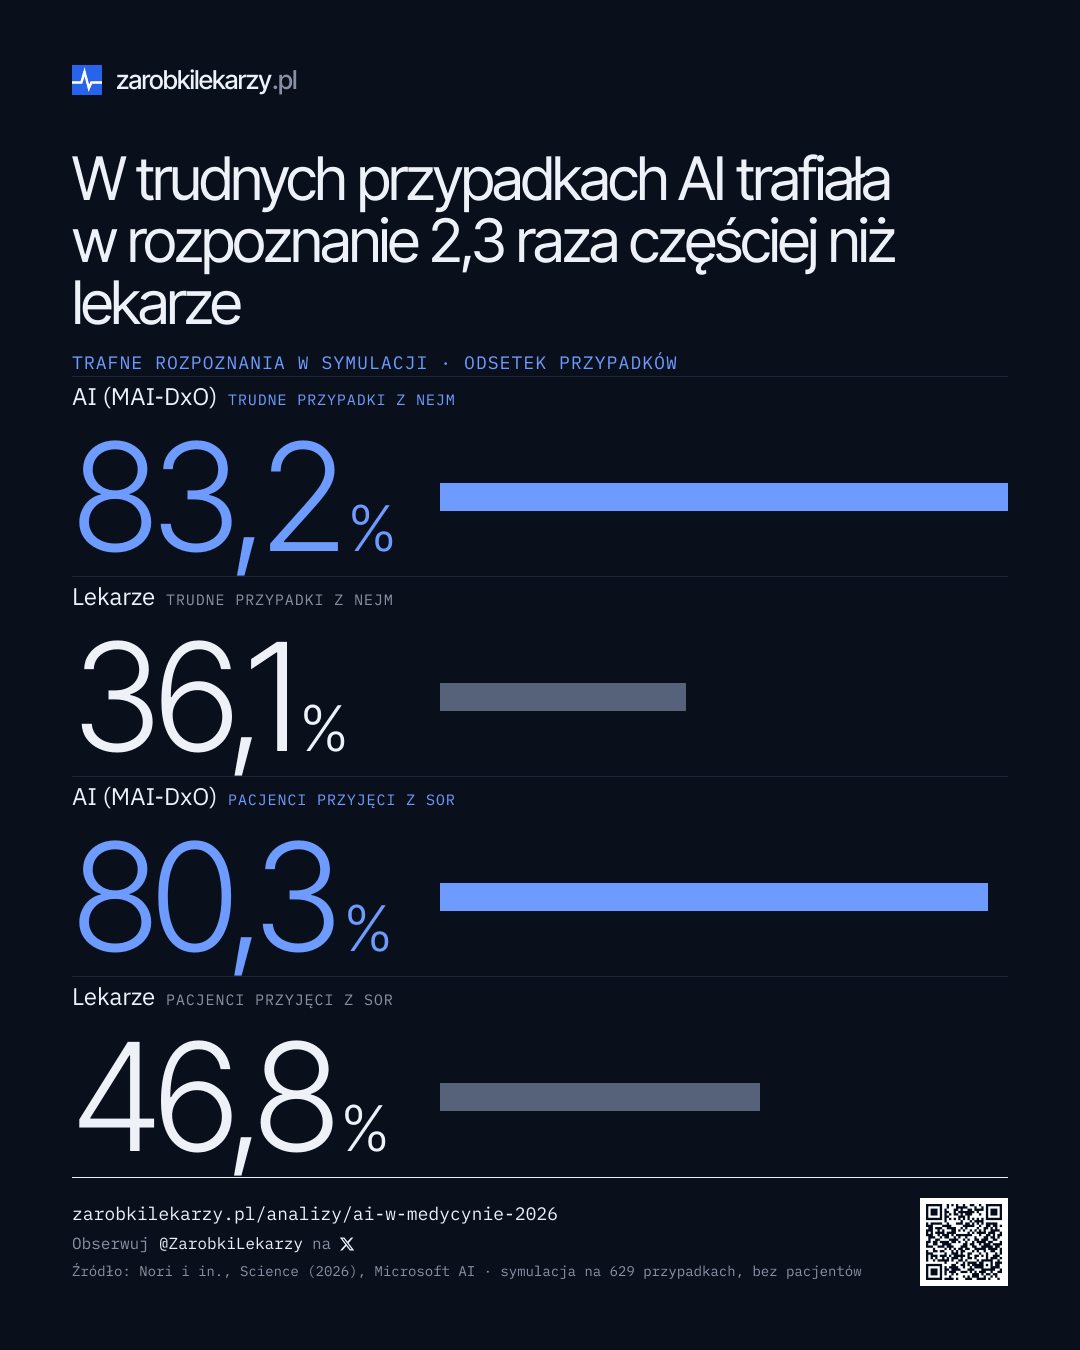
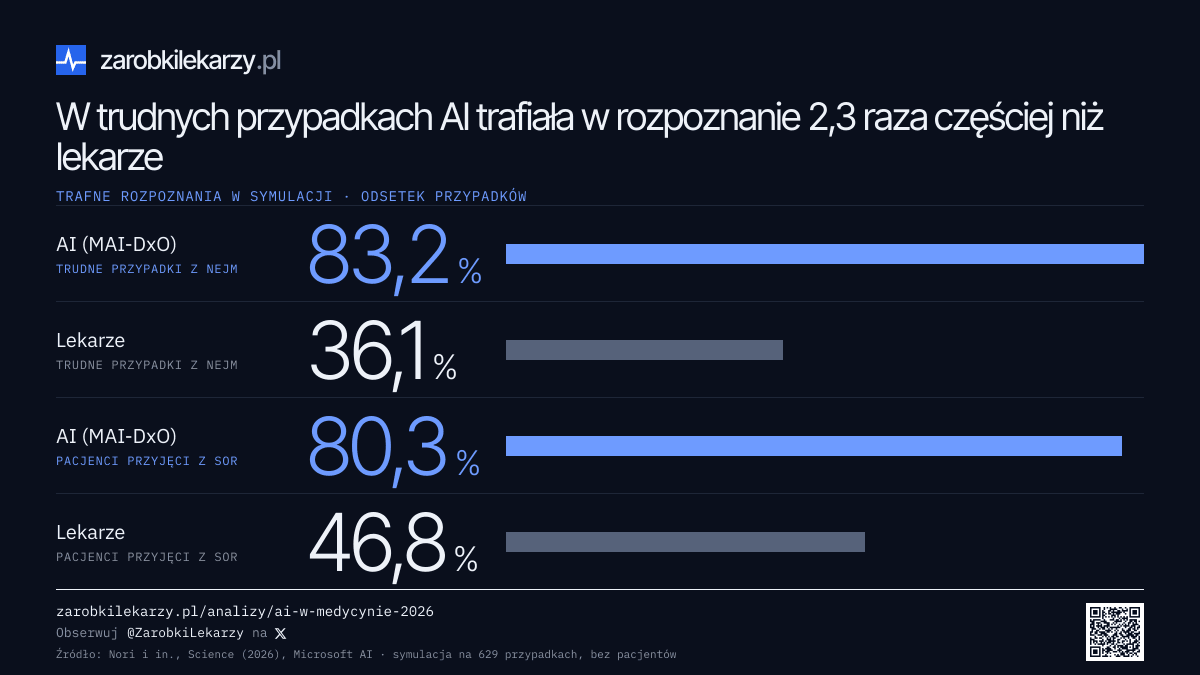
Producenci chętnie porównują modele z lekarzami. Najdokładniej opisane porównanie przygotował zespół Microsoftu, a w październiku 2026 r. opublikował je recenzowany tygodnik Science. Badacze zamienili 304 trudne przypadki opisane w New England Journal of Medicine (NEJM) i 325 przyjęć do szpitala z SOR w Bostonie w zadania krok po kroku: lekarz albo AI dostaje krótki opis pacjenta i sam decyduje, o co dopytać i jakie badania zlecić. Każde badanie ma cenę, więc oprócz trafności liczy się koszt diagnostyki. System MAI-DxO, działający na modelu GPT-5, symuluje zespół lekarzy, którzy omawiają możliwe rozpoznania i wybierają tańsze badania. Trafił w rozpoznanie w 83,2% trudnych przypadków i w 80,3% przypadków z SOR. Lekarze z USA i Wielkiej Brytanii — lekarze rodzinni i szpitalni bez wąskiej specjalizacji, z medianą 12 lat doświadczenia — w 36,1% i 46,8%.8
W symulacji AI trafiała w rozpoznanie częściej niż lekarze
Wynik pochodzi z symulacji, a nie z pracy z pacjentami — autorzy sami to zastrzegają. Lekarze mogli korzystać z podręczników i wytycznych, np. UpToDate, ale nie z narzędzi AI ani z pomocy kolegów, a przypadki z NEJM wybiera się właśnie dlatego, że są nietypowe. Lekarze rozwiązywali tylko część zadań: 56 najnowszych przypadków z NEJM i 71 z SOR. Taniej od lekarzy wypada tylko wariant z limitem kosztów (2241 USD przy trafności 80,9%) — najtrafniejszy wariant zlecał badania za 5430 USD na przypadek, więcej niż lekarze (4725 USD). Koszty to wycena zleconych badań według cennika amerykańskiego systemu szpitalnego, a nie rzeczywiste wydatki.9 Badanie przeprowadzili pracownicy Microsoftu, a firma zastrzega, że system nie jest dopuszczony do użytku klinicznego.10 Takie porównania mówią więcej o możliwościach modelu niż o tym, jak sprawdziłby się w gabinecie.
Obok usług zamkniętych rozwijają się modele otwarte. Google udostępnia model MedGemma, ale zaznacza, że nie jest on jeszcze gotowy do zastosowań klinicznych i przed użyciem trzeba go zweryfikować.11 Politechnika Federalna w Lozannie (EPFL) wydała w czerwcu 2026 r. modele MeditronFO i opublikowała razem z nimi dane, kod, procedurę treningu i sposób oceny.12 Taki model może sprawdzić każdy — także szpital, który chciałby go wdrożyć.
Polska: modele decyzyjne
W Polsce powstają modele innego typu niż czatboty. Model decyzyjny nie pisze odpowiedzi: dostaje opis sytuacji i listę dozwolonych opcji, a zwraca prawdopodobieństwo każdej z nich w jednym przebiegu. Nie może więc „dopowiedzieć” czegoś spoza listy, a jego pewność da się zmierzyć i porównać z rzeczywistością.
Basal to rodzina takich modeli. Nie są to modele medyczne — służą do rozstrzygnięć typu „wybierz jedną z opcji”, np. kierowania zgłoszeń czy oceny pilności. Medycyna to tylko jeden z obszarów, w których je sprawdzono. Główny model wersji 2.0, zbudowany na polskim modelu Bielik, odpowiada poprawnie na 62,0% pytań z Lekarskiego Egzaminu Końcowego (LEK) po polsku i 63,0% po angielsku.13 Największy, basal-omni-1.0-ultra (31 mld parametrów, na modelu Gemma 4 od Google, wydany 16 października 2026 r.), odpowiada poprawnie na 86,9% pytań po polsku i 87,0% po angielsku. Na tych samych pytaniach autor zmierzył też medyczny MedDecider-31B: 87,6% i 86,9% — różnica mieści się w granicach błędu pomiaru.14 Dla porównania: żeby zdać LEK, trzeba uzyskać 56% punktów (sprawdź się w symulatorze). Pytania z LEK są jawne, więc mogły trafić do danych, na których uczono modele bazowe — wyniki egzaminacyjne trzeba czytać z tym zastrzeżeniem. Modele są udostępnione na otwartej licencji Apache 2.0, a autor zastrzega, że decyzje o poważnych skutkach dla ludzi powinien weryfikować człowiek.
Autor modeli Basal
Remek Kinas
@KinasRemek
Rozwija Basal — otwarte modele decyzyjne oparte na polskim modelu Bielik, sprawdzane m.in. na pytaniach z LEK.
MedDecider to rodzina modeli medycznych tego samego typu, wydana w październiku 2026 r. przez thelion.ai — kolektyw programistów i badaczy, który powstał na Politechnice Gdańskiej. Modele mają sprawdzać leki i rozpoznania w notatkach klinicznych, kwalifikować pacjentów do badań klinicznych i oceniać dowody naukowe. Trenowano je po angielsku. Na zbiorach pytań egzaminacyjnych, których modele nie widziały w treningu — m.in. trudnym zbiorze MedXpertQA i polskim egzaminie specjalizacyjnym — odsetek poprawnych odpowiedzi wynosi średnio 55–70%, zależnie od wielkości modelu.15 Na pytaniach z LEK (4722 pytania z 26 sesji z lat 2008–2026) największy pojedynczy model, MedDecider-31B, odpowiada poprawnie na 87,7%, a połączenie dwóch największych modeli (MedDecider Duo) — na 89,2%. Na 286 pytaniach z sesji 2025–2026 MedDecider-31B uzyskał 89,9%; średni wynik zdających na tych sesjach wyniósł według autorów 71,3%.16 Autorzy piszą wprost, że to modele badawcze, a nie wyroby medyczne, i że notatki kliniczne użyte w treningu były syntetyczne.
Autor modeli MedDecider
Aleksander Obuchowski
@AlexObuchowski
Tworzy MedDecider w thelion.ai — otwarte medyczne modele decyzyjne, sprawdzane m.in. na pytaniach z polskich egzaminów specjalizacyjnych.
Państwo zapowiada własne zastosowania. Ministerstwo Zdrowia chce wprowadzić do Internetowego Konta Pacjenta narzędzia AI objaśniające wyniki badań i oceniające pilność,17 a asystent głosowy w centralnej e-rejestracji miał od 1 października 2026 r. przypominać o wizytach osobom, które podały tylko numer telefonu stacjonarnego.18 Resort wskazał też pierwsze algorytmy do analizy badań obrazowych dla szpitali — opisujemy je niżej, w części o radiologii. To na razie zapowiedzi — ocenimy je, gdy zaczną działać.
Wywiad prowadzony przez AI
Rozpoznanie zaczyna się od wywiadu: lekarz dopytuje o objawy, ich przebieg i choroby przewlekłe. W badaniu oksfordzkim rozmowę prowadzili sami użytkownicy i to oni podawali modelom niepełne informacje.1 Google sprawdza odwrotny układ — system AMIE sam prowadzi wywiad i dopytuje pacjenta. To narzędzie badawcze, niedostępne publicznie.19
W badaniu z losowym przydziałem i podwójnie ślepą oceną AMIE i 20 lekarzy podstawowej opieki zdrowotnej przeprowadzało konsultacje na czacie z aktorami odgrywającymi pacjentów, w 159 scenariuszach z Kanady, Wielkiej Brytanii i Indii. AMIE trafniej rozpoznawał choroby i według lekarzy specjalistów wypadł lepiej w 30 z 32 ocenianych kryteriów, a według aktorów — w 25 z 26, m.in. w empatii. Autorzy zastrzegają, że lekarze pracowali na czacie tekstowym, którego na co dzień nie używają, a pacjentów grali aktorzy.20
Pierwsze badanie z prawdziwymi pacjentami przeprowadzono w przychodni szpitala Beth Israel Deaconess w Bostonie. Z 114 zapisanych pacjentów 98 porozmawiało z AMIE do pięciu dni przed wizytą w trybie pilnym, a lekarze nadzorujący śledzili każdą rozmowę na bieżąco. Żadnej nie musieli przerwać; odnotowali jedną halucynację, a w pięciu rozmowach uzupełnili informacje kliniczne. Lekarze, którzy przed wizytą przeczytali zapis rozmowy, uznali go za pomocny w 33 z 44 przypadków. Badanie sfinansował Alphabet, właściciel Google.21 We wcześniejszej wersji pracy, sprzed recenzji, autorzy podali też, że ostateczne rozpoznanie znalazło się na liście możliwych rozpoznań AMIE w 90% przypadków, a jakość rozpoznań i planów leczenia była podobna jak u lekarzy — lekarze proponowali leczenie bardziej praktyczne i tańsze.22 Przewaga z symulacji nie przeniosła się więc wprost do przychodni, ale system zebrał wywiad bezpiecznie i przygotował lekarza do wizyty.
Radiologia: tu AI już pracuje
Najwięcej dopuszczonych do użytku algorytmów służy radiologii — na liście amerykańskiej FDA to 76% wyrobów medycznych z AI.23 Takie programy zaznaczają podejrzane zmiany na zdjęciach, ustawiają kolejność opisów tak, by pilne badania trafiały do lekarza najpierw, albo pełnią rolę drugiego czytającego. W badaniach opisanych niżej ostateczną ocenę zawsze wydawał radiolog.
Najmocniejsze dowody pochodzą z mammografii przesiewowej. W szwedzkim badaniu z losowym przydziałem, obejmującym ponad 105 tys. kobiet, program z AI wykrył 6,4 raka na 1000 badanych wobec 5,0 w standardowym programie, przy podobnym odsetku fałszywych alarmów. Radiolodzy mieli przy tym o 44,2% mniej odczytów, bo zdjęcia ocenione przez AI jako niskiego ryzyka oglądał jeden lekarz zamiast dwóch.24 Raków rozpoznanych między kolejnymi badaniami przesiewowymi — przeoczonych albo takich, które rozwinęły się w tym czasie — było w grupie z AI 1,55 na 1000, a w grupie standardowej 1,76; różnica nie jest istotna statystycznie, ale AI nie pogorszyła wyników.25 W Niemczech, w badaniu obserwacyjnym 463 tys. kobiet i 119 radiologów, wykrywalność z AI była o 17,6% wyższa bez wzrostu liczby wezwań na dodatkowe badania; część autorów deklaruje powiązania z producentem oprogramowania.26 Żadne z tych badań nie pokazało jeszcze, czy dzięki AI mniej kobiet umiera na raka piersi.
AI może też zaszkodzić, gdy lekarz za bardzo jej ufa. W eksperymencie z udziałem 27 radiologów, którym rzekomy system AI podpowiadał ocenę mammogramu, odsetek trafnych ocen przy błędnej podpowiedzi spadł u najmniej doświadczonych z 79,7% do 19,8%, a u najbardziej doświadczonych — z 82,3% do 45,5%.27
W Chinach AI w obrazowaniu jest już szeroko dopuszczona i używana. Według przeglądu opublikowanego w JMIR Medical Informatics chiński urząd nadzoru nad lekami i wyrobami medycznymi (NMPA) dopuścił do połowy 2025 r. 154 wyroby medyczne z AI, z czego 123 w najwyższej klasie ryzyka. 106 z nich (68,8%) służy radiologii, najczęściej do wykrywania guzków płuc w tomografii.28 W ogólnokrajowej ankiecie z 2023 r., w której wzięło udział 6726 radiologów z 1143 szpitali, 3017 zadeklarowało, że korzysta z AI regularnie. Ankietę prowadzono w szpitalach objętych krajowym systemem kontroli jakości radiologii, więc nie mówi ona, jaki odsetek wszystkich chińskich szpitali używa AI.29 Pełne upowszechnienie to wciąż plan: według rządowych wytycznych z października 2025 r. do 2030 r. AI ma wspomagać diagnostykę obrazową powszechnie w szpitalach II i III stopnia.30 Szybko trafiły tam też modele językowe. W ciągu miesiąca od pierwszego wdrożenia, 10 lutego 2025 r., model DeepSeek uruchomiło 37 ze 100 czołowych chińskich szpitali, a do końca czerwca — 48, głównie do wspomagania rozpoznań i doboru leczenia. Tylko 21 z 58 opisanych wdrożeń wskazywało, że model oceniono przed uruchomieniem.31
W Polsce jest 4434 specjalistów radiologii i diagnostyki obrazowej oraz 554 lekarzy ze specjalizacją I stopnia (stan na 30 czerwca 2026 r.).32 Ministerstwo Zdrowia wskazało pięć pierwszych narzędzi AI dla szpitali w ramach Platformy Usług Inteligentnych Centrum e-Zdrowia: do tomografii klatki piersiowej, obrazowania mózgu przy udarze i krwawieniu, zdjęć RTG kości po urazach, mammografii i RTG klatki piersiowej. Skorzystać ma z nich do 400 szpitali z umową z NFZ.3334 Nie znaleźliśmy osobnej wyceny NFZ za użycie AI w diagnostyce obrazowej ani wdrożenia AI w publicznym programie badań mammograficznych.
Roboty chirurgiczne: ręce chirurga, nie AI
Robot chirurgiczny w szpitalu nie operuje sam. Najpopularniejszy system, da Vinci, przenosi na narzędzia ruchy chirurga siedzącego przy konsoli — każde cięcie i szew wykonuje człowiek. Przegląd 49 robotów chirurgicznych dopuszczonych w USA w latach 2015–2023 wykazał, że 42 (86%) działają na najniższym poziomie autonomii — jako narzędzie w rękach chirurga — a żaden nie osiąga poziomu, na którym robot sam prowadzi operację.35
W Polsce roboty pracują w ramach publicznego systemu. NFZ finansuje robotowe operacje raka prostaty od kwietnia 2022 r., a od sierpnia 2023 r. także raka trzonu macicy i raka jelita grubego.3637 Według raportu Modern Healthcare Institute w 2025 r. wykonano 24 585 zabiegów z użyciem robota, o 44% więcej niż rok wcześniej. Wykonywały je 93 szpitale, a 98% zabiegów sfinansował NFZ.38
Samodzielne operacje robotów sterowanych przez AI odbywają się na razie tylko w laboratoriach. W 2025 r. zespół Uniwersytetu Johnsa Hopkinsa w USA opisał system, który bez sterowania przez człowieka wykonał etap usuwania pęcherzyka żółciowego — zaciskanie klipsami i przecinanie przewodu pęcherzykowego oraz tętnicy. Zrobił to bezbłędnie na 8 preparatach, ale na narządach świńskich poza organizmem, wolniej niż chirurg, a narzędzia wymieniał człowiek.39 W lipcu 2026 r. zespół Uniwersytetu Kalifornijskiego w San Diego opisał pierwsze operacje wykonane przez roboty humanoidalne — na zwierzętach, a roboty w całości sterowali chirurdzy.40
Pierwsze badanie z udziałem pacjentów, w którym AI steruje częścią robota, prowadzi Chiński Uniwersytet w Hongkongu. Badanie ruszyło w czerwcu 2026 r. i ma objąć 10 pacjentów. Podczas usuwania pęcherzyka żółciowego sterowane głosem ramię robota wykonuje zadania pomocnicze, a główne narzędzia prowadzi chirurg.41 Przegląd badań nad robotami chirurgicznymi, które uczą się metodą prób i błędów (tzw. uczenie ze wzmocnieniem), opublikowany w sierpniu 2026 r., nie odnotował żadnego zabiegu, w którym taki robot działałby samodzielnie u człowieka.42
Certyfikacja: największy hamulec
Modele potrafią więcej, niż wolno im robić przy pacjencie. Powód jest prosty: program, który pomaga postawić diagnozę albo dobrać leczenie, jest w świetle prawa wyrobem medycznym — tak samo jak tomograf czy pompa insulinowa.
W Unii Europejskiej decyduje o tym rozporządzenie o wyrobach medycznych (MDR). Oprogramowanie, które dostarcza informacji wykorzystywanych przy decyzjach diagnostycznych lub terapeutycznych, należy co najmniej do klasy IIa. Gdy skutkiem błędnej decyzji może być zgon albo nieodwracalne pogorszenie zdrowia — do klasy III.43 Takie wyroby ocenia jednostka notyfikowana, czyli niezależna instytucja wyznaczona przez państwo. W UE działa 53 takie jednostki. W ankiecie Komisji Europejskiej z 2026 r. ponad połowa z nich podała, że pełna certyfikacja trwa zwykle 13–18 miesięcy, a niemal jedna trzecia — 19–24 miesiące.44 Dochodzą do tego wymogi unijnego aktu o sztucznej inteligencji (AI Act), który uznaje AI w wyrobach medycznych za system wysokiego ryzyka. Te obowiązki miały wejść w życie w sierpniu 2027 r., ale w lipcu 2026 r. Unia przesunęła je na 2 sierpnia 2028 r.45
Największa trudność nie wynika jednak z długości procedury, tylko z natury modeli. Certyfikat dotyczy konkretnej, zamrożonej wersji wyrobu, a istotna zmiana wymaga ponownej oceny. Ogólne modele językowe są często aktualizowane i nie mają jednego, wąsko określonego zastosowania — trudno je więc przeprowadzić przez procedurę pomyślaną dla wyrobów o stałym działaniu. Amerykańska Agencja Żywności i Leków (FDA) pozwala producentowi uzgodnić z góry plan przyszłych zmian (tzw. PCCP), co częściowo rozwiązuje ten problem.46
Efekt widać w rejestrach. Na liście FDA jest 1614 wyrobów medycznych z AI, z czego 76% dotyczy radiologii.23 To wąskie algorytmy: wykrywają zmiany na zdjęciach, mierzą parametry, oznaczają pilne badania. Polskie firmy również mają certyfikaty CE dla takich algorytmów, m.in. do analizy długotrwałego zapisu EKG, tomografii głowy i tomografii serca.474849 Nadzór nad rynkiem wyrobów medycznych sprawuje w Polsce Prezes Urzędu Rejestracji Produktów Leczniczych, Wyrobów Medycznych i Produktów Biobójczych.50 Żaden ogólny model językowy — ani polski, ani zagraniczny — nie ma certyfikatu wyrobu medycznego. Dlatego twórcy asystentów i modeli — od OpenAI po autorów MedDecidera — zastrzegają, że ich narzędzia nie służą do diagnozy albo nie są wyrobami medycznymi.
Certyfikacja nie jest jednak biurokracją dla zasady. To jedyny mechanizm, który wymaga od producenta dowodu skuteczności i bezpieczeństwa oraz wskazuje, kto odpowiada za błąd. Wyniki egzaminów i porównania przygotowane przez producentów takiego dowodu nie dają, co pokazały badania z Oksfordu i Mount Sinai. Pytanie nie brzmi więc, czy certyfikować modele, tylko jak sprawdzać narzędzia, które ciągle się zmieniają.
Stan na 2026
- Modele językowe dobrze odpowiadają na pytania medyczne, ale ludzie, którzy z nich korzystają, nie podejmują przez to lepszych decyzji o zdrowiu.
- Przy pacjentach pracują głównie wąskie, certyfikowane algorytmy — zwłaszcza w radiologii i kardiologii — a nie czatboty.
- Robot w polskim szpitalu to refundowane narzędzie chirurga. Samodzielne operacje robotów z AI odbywają się na razie w laboratoriach.
- Polskie zespoły budują otwarte modele, które można sprawdzić. O tym, kiedy trafią do leczenia, zdecyduje certyfikacja — tak samo jak na świecie.
Wspólny mianownik jest ten sam co przy pieniądzach publicznych: zaufanie wymaga sprawdzalności. Model, którego dane, wyniki i ograniczenia są jawne, łatwiej ocenić — i łatwiej mu zaufać.
Przypisy 50ustawy, dane i komunikaty, z których korzystaliśmy
-
A. M. Bean i in., Reliability of LLMs as medical assistants for the general public: a randomized preregistered study, Nature Medicine 32 (2026), s. 609–615. Badanie objęło 1298 osób z Wielkiej Brytanii i trzy modele (GPT-4o, Llama 3, Command R+); grupa kontrolna korzystała z dowolnych źródeł, najczęściej z wyszukiwarki. ↩ ↩2 ↩3
-
OpenAI, Przedstawiamy ChatGPT Health, 7.01.2026. ↩
-
Anthropic, Advancing Claude in healthcare and the life sciences, 11.01.2026. ↩
-
Mount Sinai, komunikat o badaniu „ChatGPT Health performance in a structured test of triage recommendations”, Nature Medicine, 23.02.2026. ↩
-
MedCity News, o modelu biznesowym i wycenie OpenEvidence, luty 2026. ↩
-
Komunikat OpenEvidence (Business Wire) z 21.01.2026, przedruk. Liczba konsultacji to dane spółki, niezweryfikowane niezależnie. ↩
-
L. De Angelis i in., The Need for Regulatory Certainty on Medical AI: Lessons From the OpenEvidence Geoblocking in the EU and UK Over the EU AI Act, The Lancet Regional Health – Europe 65 (2026), 101718. ↩
-
H. Nori i in., Sequential diagnosis with language models, Science, 22.10.2026. Autorzy to zespół Microsoft AI. Trafność, liczba przypadków i wyniki lekarzy — według streszczenia pracy. ↩
-
H. Nori i in., Sequential Diagnosis with Language Models, pełna wersja pracy udostępniona przez współautora, 8.11.2025, s. 2 i 13–17. Stąd pochodzą koszty i opis grupy lekarzy; streszczenie w Science podaje te same wyniki trafności. ↩
-
Microsoft AI, The Path to Medical Superintelligence, 30.06.2025. ↩
-
Google, MedGemma — opis modelu. ↩
-
EPFL, EPFL launches the world’s first fully open medical LLMs, czerwiec 2026. ↩
-
Karta modelu basal-2.0-4.5B (Hugging Face) i strona projektu. Wyniki podaje autor; test LEK z pięcioma opcjami odpowiedzi. ↩
-
R. Kinas, basal-omni-1.0-ultra i silnik basal 2.1, blog projektu Basal, 16.10.2026. Pomiar autora Basala; MedDecider uruchomiono skryptem jego autorów. 95% przedział dla MedDecider-31B: 86,6–88,5% po polsku, 85,7–88,0% po angielsku. ↩
-
thelion.ai, karta modelu MedDecider-4B (Hugging Face), październik 2026. Wyniki podają autorzy. ↩
-
thelion.ai, karta modelu MedDecider-31B (Hugging Face), październik 2026. Wyniki podają autorzy; 4722 pytania z 26 sesji LEK, wszystkie sesje zaliczone. ↩
-
Pion.pl, AI na IKP — nowe plany Ministerstwa Zdrowia, 21.05.2026. ↩
-
Alert Medyczny, Asystent AI w e-rejestracji nie od 1 lipca — ministerstwo przesuwa termin. ↩
-
Google Research, AMIE: A research AI system for diagnostic medical reasoning and conversations. ↩
-
T. Tu i in., Towards conversational diagnostic artificial intelligence, Nature 642 (2025), s. 442–450. Badanie przeprowadził zespół Google. ↩
-
Brodeur i in., Conversational diagnostic artificial intelligence in ambulatory primary care: a prospective feasibility study, The Lancet, październik 2026 (NCT06911398). ↩
-
A prospective clinical feasibility study of a conversational diagnostic AI in an ambulatory primary care clinic, arXiv:2603.08448, marzec 2026 — wersja sprzed recenzji, 100 pacjentów. Różnica w jakości rozpoznań nieistotna statystycznie (p = 0,6); w pierwszej trójce rozpoznań AMIE — 75%. ↩
-
FDA, Artificial Intelligence-Enabled Medical Devices — wyliczenie z tabeli, decyzje do 29.06.2026. ↩ ↩2
-
V. Hernström i in., Screening performance and characteristics of breast cancer detected in the Mammography Screening with Artificial Intelligence trial (MASAI), The Lancet Digital Health 7 (2025), e175–e183. Odczyty: 61 248 w grupie z AI wobec 109 692 w grupie kontrolnej. ↩
-
J. Gommers i in., Interval cancer, sensitivity, and specificity comparing AI-supported mammography screening with standard double reading without AI in the MASAI study, The Lancet 407 (2026), s. 505–514. Badanie objęło 105 934 kobiety; stosunek 0,88 (95% CI 0,65–1,18), czułość 80,5% wobec 73,8%. ↩
-
N. Eisemann i in., Nationwide real-world implementation of AI for cancer detection in population-based mammography screening, Nature Medicine 31 (2025), s. 917–924. Wykrywalność 6,7 wobec 5,7 na 1000; radiolodzy sami decydowali, czy używają AI. ↩
-
T. Dratsch i in., Automation Bias in Mammography: The Impact of Artificial Intelligence BI-RADS Suggestions on Reader Performance, Radiology 307 (2023), e222176. ↩
-
L. Zhang i in., Approval of AI-Based Medical Devices in China From 2020 to 2025: Retrospective Analysis, JMIR Medical Informatics, 18.03.2026. Stan na 30.06.2025; autorzy policzyli wyroby w komercyjnej bazie rejestracji, oficjalnego zestawienia NMPA nie ma. ↩
-
H. Liu i in., Artificial Intelligence and Radiologist Burnout, JAMA Network Open, 2024. Ankieta z maja–października 2023 r.; do grupy korzystających zaliczono osoby deklarujące regularne lub stałe użycie AI. ↩
-
Narodowa Komisja Zdrowia i cztery inne urzędy, 关于促进和规范“人工智能+医疗卫生”应用发展的实施意见 (wytyczne o rozwoju zastosowań AI w ochronie zdrowia), 国卫办规划发〔2025〕30号, 20.10.2025. ↩
-
W. Jiang i in., Promoting Responsible DeepSeek Deployment in Health Care: Scoping Review Comparing Grey and White Literature, Journal of Medical Internet Research, 5.12.2025. Dane ze stron i kont WeChat szpitali, stan na 28.06.2025. ↩
-
Naczelna Izba Lekarska, zestawienie liczbowe lekarzy według dziedzin i stopni specjalizacji, stan na 30.06.2026. Wykonujących zawód: 4276 specjalistów i 464 lekarzy z I stopniem. ↩
-
Rynek Zdrowia, AI wkroczy do diagnostyki w szpitalach. Ministerstwo Zdrowia wskazało narzędzia dla lekarzy, 2.09.2026. ↩
-
Debaty Zdrowie, Szpitale mają otrzymać dostęp do krajowej platformy AI w 2026 roku, 24.09.2026. ↩
-
A. Lee i in., Levels of autonomy in FDA-cleared surgical robots: a systematic review, npj Digital Medicine, 2024. Poziom 1: 42 systemy, poziom 2: 4, poziom 3: 3, poziomy 4–5: żaden. ↩
-
Rozporządzenie Ministra Zdrowia z 25.01.2022 r. zmieniające rozporządzenie w sprawie świadczeń gwarantowanych z zakresu leczenia szpitalnego, Dz.U. 2022 poz. 245 (w mocy od 1.04.2022). ↩
-
Rozporządzenie Ministra Zdrowia z 28.07.2023 r., Dz.U. 2023 poz. 1477 (w mocy od 1.08.2023). ↩
-
Modern Healthcare Institute, Raport: chirurgia robotowa w Polsce 2026, dane za 2025 r. Liczba szpitali dotyczy robotów do operacji tkanek miękkich. ↩
-
J. W. Kim i in., SRT-H: A hierarchical framework for autonomous surgery via language-conditioned imitation learning, Science Robotics, 9.07.2025. ↩
-
UC San Diego, Surgeons use teleoperated humanoid robots to perform live surgery, lipiec 2026 (publikacja w Nature). ↩
-
ClinicalTrials.gov, NCT07705828: AI-Assisted Cholecystectomy With Laparoscopic Surgical Robot: A First-in-Human Study, Chinese University of Hong Kong. ↩
-
Applications of Reinforcement Learning for Autonomous Surgical Robotics: A Systematic Review, Biomimetics 11 (2026), 577 — obejmuje publikacje do marca 2026 r. ↩
-
Rozporządzenie (UE) 2017/745 w sprawie wyrobów medycznych, załącznik VIII, reguła 11. ↩
-
Komisja Europejska, ankieta wśród jednostek notyfikowanych, dane do 28.02.2026. Przy certyfikacji systemu jakości i produktu 51% jednostek podaje 13–18 miesięcy, 31% — 19–24 miesiące; ankieta nie wyodrębnia oprogramowania z AI. ↩
-
Rozporządzenie (UE) 2026/1744 z 8.07.2026 r. (akt zbiorczy prawa cyfrowego dotyczący AI), pkt 40 zmieniający art. 113 rozporządzenia (UE) 2024/1689 — dotyczy systemów wysokiego ryzyka z art. 6 ust. 1. ↩
-
FDA, Predetermined Change Control Plan — ostateczne wytyczne, grudzień 2024. ↩
-
Cardiomatics, komunikat o certyfikacie MDR, 17.10.2023 — informacja producenta. ↩
-
Rynek Zdrowia, rozmowa z prezesem Brainscan, 10.04.2024. ↩
-
Hemolens Diagnostics, komunikat o certyfikacie CE, 26.06.2026 — informacja producenta. ↩
-
Ustawa z 7.04.2022 r. o wyrobach medycznych, Dz.U. 2022 poz. 974. ↩
Infografiki do pobrania
2 grafiki · pion i poziom, jasna i ciemna
Grafiki do udostępnienia w dwóch formatach: pionowym 1080×1350 (Instagram, Facebook, X) i poziomym 1200×675 (X, LinkedIn, prezentacje), w wersji jasnej i ciemnej. Źródła, adres strony i kod QR do niej są na grafice.
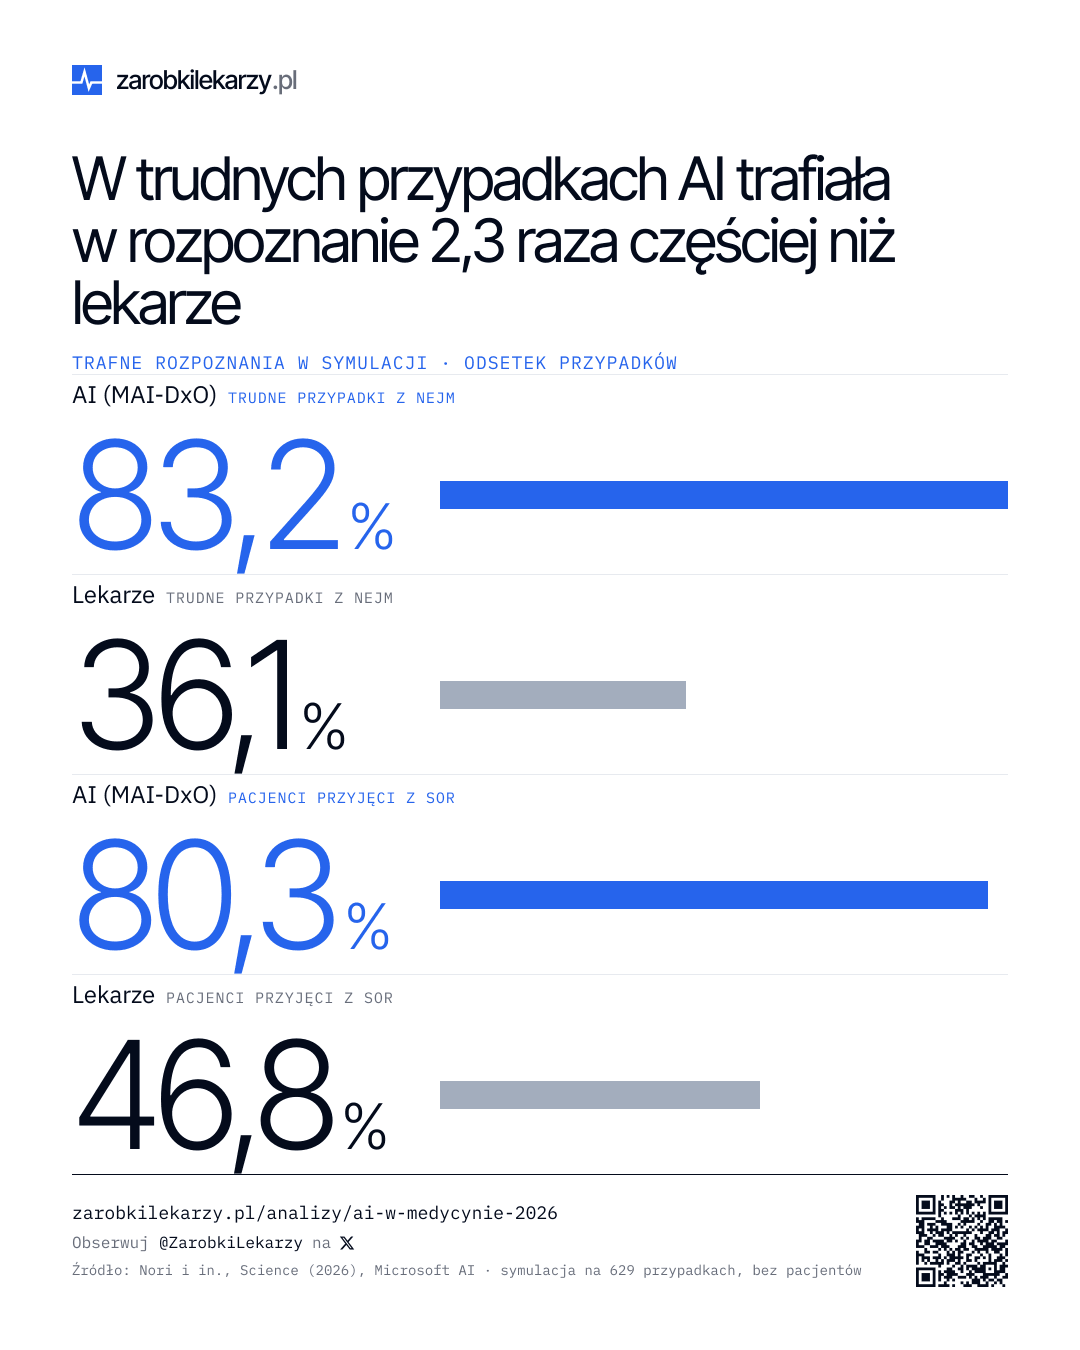
W trudnych przypadkach AI trafiała w rozpoznanie 2,3 raza częściej niż lekarze
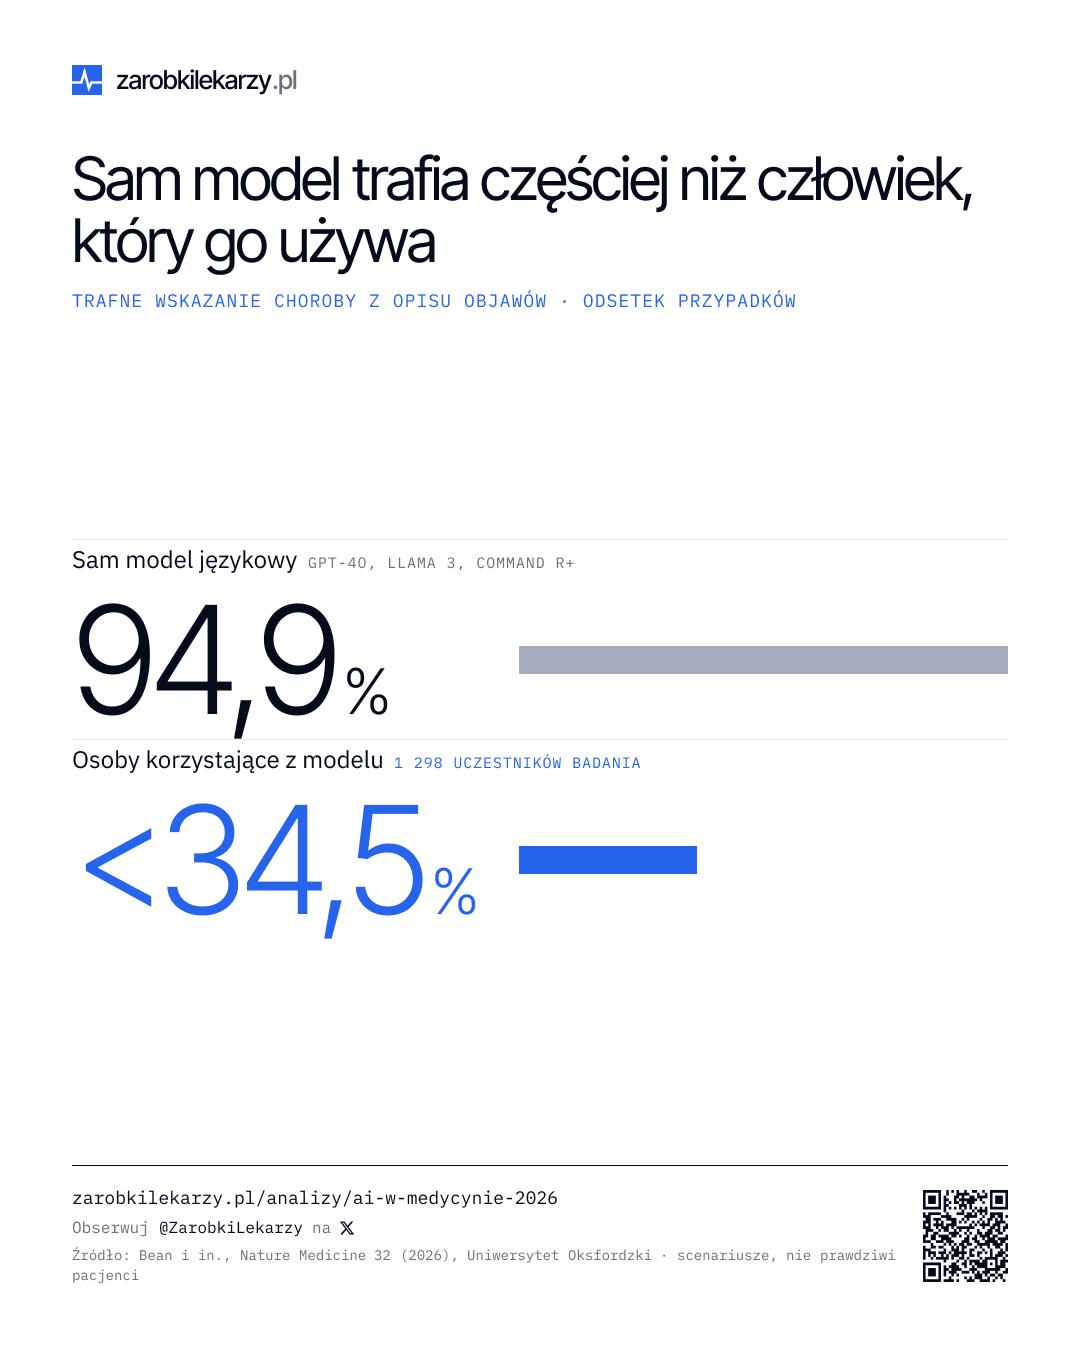
Sam model trafia częściej niż człowiek, który go używa